Cómo funciona la implementación desatendida de nuestra software factory, por qué el workflow tardaba el doble que la skill a la que sustituía y qué ajustamos para bajarlo, y cuándo te conviene subir de modelo frente a subir el esfuerzo de razonamiento. Y cómo mirar a largo plazo cambia nuestra forma de afrontar decisiones sobre la IA, el equipo y los clientes.
IA en 540
01. Nuestra software factory (II): la implementación desatendida
Seguimos con nuestra software factory, esta vez con la implementación: recibe una tarea especificada y entrega una PR con el código y los tests que la cumplen. La persona solo entra al principio, para especificar, y al final, para hacer el merge.
Empezamos lanzando skills a mano, pasamos a una skill que las encadenaba y acabamos migrándola a un workflow determinista: el código fija las fases, el orden, los bucles y qué comprobaciones hay que pasar para avanzar.
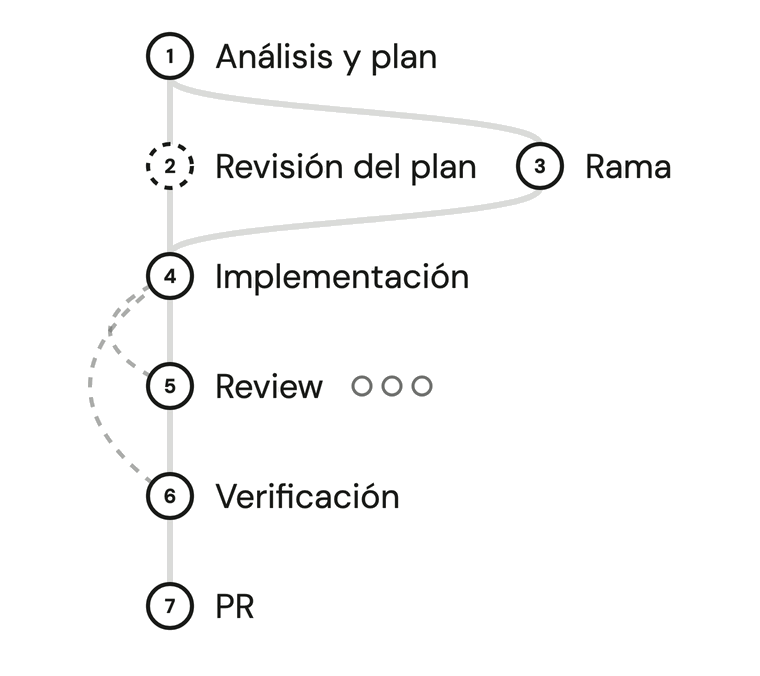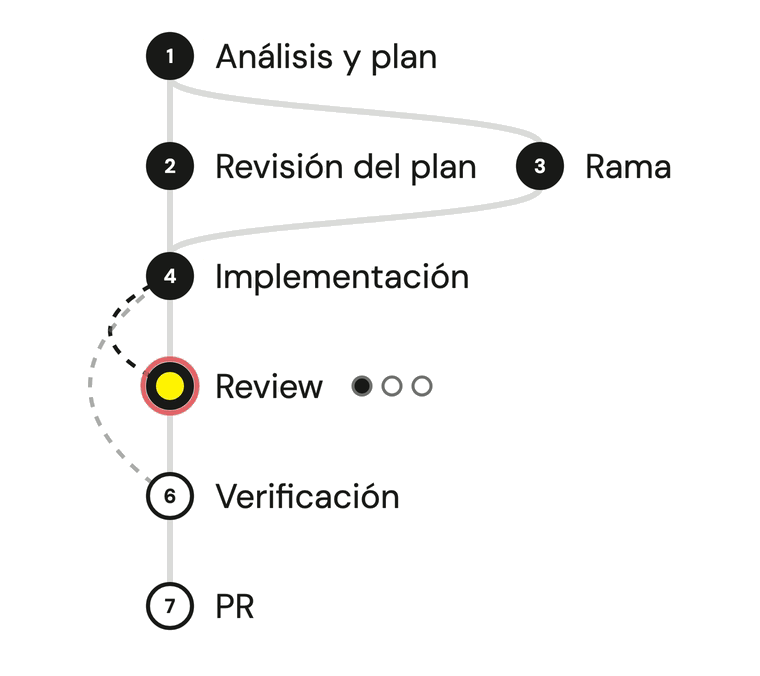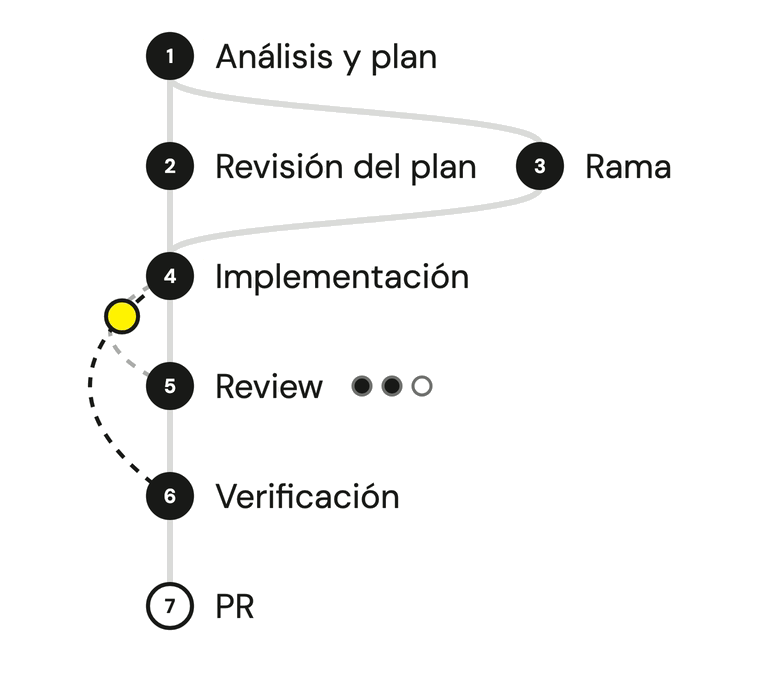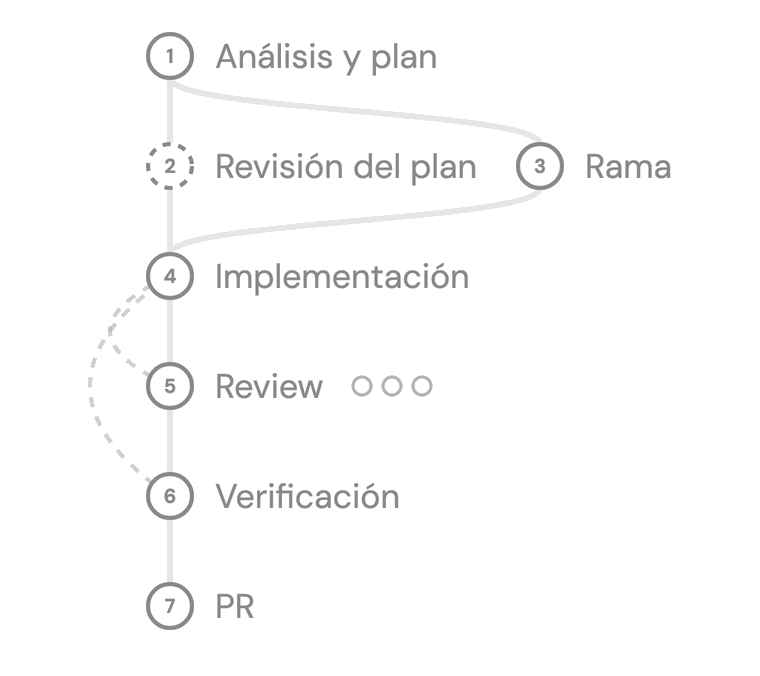
Estas son sus fases:
Análisis y plan. Entiende la tarea y escribe el plan. Si llega sin criterios de aceptación o con preguntas abiertas, el workflow se para.
Revisión del plan y creación de la rama. Otro agente revisa el plan para simplificarlo y corregirlo.
Implementación. Escribe el código y los tests.
Review. Pasan los checks deterministas y la review de otro agente, y lo que falla vuelve, hasta tres rondas.
Verificación. Si la review pasa, ejecuta el código y lo prueba (en el navegador, en el simulador…) contra los criterios de aceptación. Si falla, vuelve a implementación.
PR. Abre la PR con lo necesario para revisarla.
Hoy los agentes escriben el 100% del código y estimamos que entre el 80 y el 90% no se lee. Queremos dejar de leerlo del todo y preocuparnos solo de la especificación que entra y de las comprobaciones que validan lo que sale.
La semana que viene veremos la siguiente etapa de la factoría, la verificación: con tantas PRs, hay que revisarlas al mismo ritmo al que se generan.
02. ¿Es más lento el workflow?
Parte del equipo seguía con la skill previa de implement porque les parecía más rápida y barata en tokens. Lo medimos y tenían razón: para una solución similar, el workflow tardó 77 minutos y 36M tokens, y la skill 41 y 10M.
Hicimos cuatro cambios:
Correcciones tras la review. Lanzábamos otra ronda para lo que necesitaba a una persona (credenciales, infraestructura, decisiones de producto), y perdíamos 25 minutos y 7,6M tokens. Ahora va al detalle de la PR.
Tests. Ahora pasamos solo los que cubren el cambio, y la ronda baja de 17 a 6 minutos.
Linters y tipos. Cada herramienta tenía su revisor con Opus. Ahora hay uno solo con Sonnet y esfuerzo bajo que gasta 0,45M tokens en vez de 1,3M.
Implementar con Opus. Habíamos decidido usar Sonnet. Con Opus tarda 14 minutos en vez de 34 y hace 76 llamadas a herramientas en vez de 184.
Con todo, el workflow baja a 27 minutos y 10,3M tokens, más rápido que la skill y con casi el mismo gasto. Y encima ejecuta siempre todos los pasos, algo que la skill no garantizaba.
03. Modelo VS esfuerzo: sabiduría y exhaustividad
¿Qué te conviene más, un modelo de más nivel que piense poco o uno de menos que le dé muchas vueltas? Kun Chen lo analizó.
El nivel del modelo y el esfuerzo de razonamiento (reasoning effort) son dos ejes independientes. Subir de modelo da sabiduría: ha visto mucho y conecta ideas de dominios distintos. Subir el esfuerzo da exhaustividad (diligence): repasa cada opción con sus consecuencias, casos límite incluidos. Ante cien caminos, los revisa todos, pero no verá que quizá lo mejor es cavar un túnel.
Su regla: si el problema pide un genio, sube el modelo, y si pide papel y lápiz, sube el esfuerzo (si pide las dos cosas, los dos).
En nuestro workflow de implementación:
Revisar linters y tipos no pide ni genio ni papel: Sonnet y esfuerzo bajo.
Implementar, por mucho que detallemos el plan, sí pide genio: Opus con esfuerzo medio.
Enlaces de interés
The right model for every task - Francisco Moreno
Comparte la guía interna de TechnoSylva para gastar menos: elegir el modelo según lo que pide la tarea en vez del más potente por defecto, y ajustar también el esfuerzo.
La implementación, fuera de tu ordenador - Gorka Moreno
Si la implementación va desatendida, no tiene por qué correr en tu máquina, y con tres a la vez, cada una con sus contenedores, el portátil se queda sin memoria. Por ahí va DigitalOcean Managed Agents, que corre Claude Code, Codex o tu propio agente en un entorno que se pausa cuando está ocioso.
Herramientas en el radar
Simfleet, varias ramas de React Native en paralelo
Con varias implementaciones por probar, coordinábamos la ejecución para que solo una tarea a la vez usara el simulador, porque lanzar varios dejaba el ordenador frito. Esta herramienta nos permite correr tres a la vez, cada rama con su simulador y su agente.
Una vuelta y media
Por Pablo Albizu
Hace unas semanas os conté que me calenté queriéndome comprar un Mercedes de los 90, de esos fabricados para durar. Sigo con esa idea, pero no está siendo tarea fácil. Y últimamente me he visto en varias conversaciones diciendo que queremos que 540 sea la empresa en la que nos gustaría jubilarnos.
No sé si lo será, pero esa idea nos ha dado un marco mental durante estos doce años: apostar por el largo plazo en las cosas importantes para nosotros. Y eso cambia cómo afrontas ciertas situaciones.
Cuando empezamos, estábamos obsesionados con aprender a desarrollar software con buenas prácticas de ingeniería, formarnos, recorrer España de evento en evento y hacer relaciones. Invertimos a tope, sin esperar una rentabilidad inmediata. En la oficina nos gastamos cero: empezamos en un despacho en la universidad y luego vivimos muchos años de okupas en Biko.
Ahora nuestra nave es estratégica. Hemos metido una inversión difícil de justificar si no pensamos en las cosas que pueden pasar ahí en los próximos diez años.
Con la IA, más de lo mismo. Delegar cada vez más nos compensa, pero estamos dedicando mucho esfuerzo a que esa delegación sea fiable. Llevamos los agentes al límite, vemos dónde fallan y mejoramos los controles y nuestra forma de trabajar. Un esfuerzo que tiene sentido si pensamos en cómo vamos a construir software durante los próximos años.
Y esa misma mirada a largo nos obliga a adoptarla con garantías. Si el software tiene que durar años, necesitamos poder mantenerlo y evolucionarlo.
Con las personas, el cambio de mirada se ve todavía más claro. Fichamos pensando en 540, no solo en cubrir un puesto en el equipo de un cliente. Esa relación puede terminar algún día, pero queremos que la persona siga con nosotros mucho tiempo más. Y si encaja pero le quedan dos meses de baja paternal que tendrá que cogerse una vez esté con nosotros, para dentro.
¿Qué significan dos meses en diez años?
La apuesta por la cantera viene del mismo sitio. Es lenta, requiere acompañamiento, estar cerca de la universidad y crear comunidad. Hace falta paciencia. Pero si pensamos en el equipo que queremos tener dentro de unos años, el esfuerzo tiene sentido.
Con los clientes buscamos ser prescindibles, pero también aplicamos lo que dice mi padre: “donde se está bien, mucho rato”. Ayudarles a ganar autonomía puede parecer una mala decisión si solo miras la próxima factura. Nuestra experiencia es que acaba generando más confianza, más relación y más trabajo.
Tengo la sensación de que mirar a largo escasea cada vez más y es una ventaja estratégica en un mundo impaciente. No sirve para todas las decisiones, pero en las cosas centrales de 540 lo ha sido.
A veces a costa de incomodidad o un pago en el corto. Eso es lo jodido.
Dos meses pueden parecer muchísimo. Hasta que piensas en diez años.
Enlaces de interés
Charlie Munger sobre saber esperar
El toque de humor de Tubau: “Warren Buffett tiene 92 años y sigue invirtiendo a largo plazo. ¿Cuál es tu excusa?”.